Thiếu ngữ cảnh, dễ nhận dạng sai
Xử lý từng đoạn âm thanh riêng lẻ có thể khiến từ ngữ mơ hồ khó được nhận diện đúng. Bối cảnh hội thoại giúp cải thiện kết quả, nhưng không loại bỏ mọi lỗi phiên âm.
 SPEECH INTELLIGENCE
Đưa các cuộc gọi và cuộc họp vào tìm kiếm, phân tích và khai thác.
AIKNOW Voice xử lý giọng nói trực tiếp và bản ghi bằng tiếng Nhật, tiếng Anh. Phiên âm theo ngữ cảnh, phân biệt người nói và tổ chức nội dung theo chủ đề giúp tìm kiếm, rà soát hội thoại thuận tiện hơn. Thông tin cá nhân được che trên văn bản theo cấu hình trước khi nội dung được đưa vào ứng dụng tri thức doanh nghiệp.
Phiên âm là bước khởi đầu để khai thác dữ liệu hội thoại.
Tiếng ồn, ngập ngừng, từ đồng âm, thuật ngữ, tên riêng, con số và việc chuyển đổi ngôn ngữ đều có thể ảnh hưởng đến nhận dạng và diễn giải.
Xử lý từng đoạn âm thanh riêng lẻ có thể khiến từ ngữ mơ hồ khó được nhận diện đúng. Bối cảnh hội thoại giúp cải thiện kết quả, nhưng không loại bỏ mọi lỗi phiên âm.
Để phân tích hội thoại, thường cần tách lượt người nói, xử lý từ đệm, chỉnh văn bản và xác định những đoạn nội dung liên quan.
Bản phiên âm dài cần được chia thành các đoạn phù hợp để dùng cho RAG. Hội thoại cũng có thể chứa thông tin cá nhân cần được xử lý đúng quy định.
Nhận dạng giọng nói tự động (ASR) tạo ra bản phiên âm.
Nếu dừng ở phiên âm, việc phân biệt người nói, chia chủ đề và xử lý thông tin cá nhân sẽ cần thực hiện ở các bước sau. Mỗi hệ thống ASR sử dụng ngữ cảnh khác nhau; so sánh này chỉ thể hiện phạm vi của quy trình.
Phiên âm là một phần của quy trình xử lý.
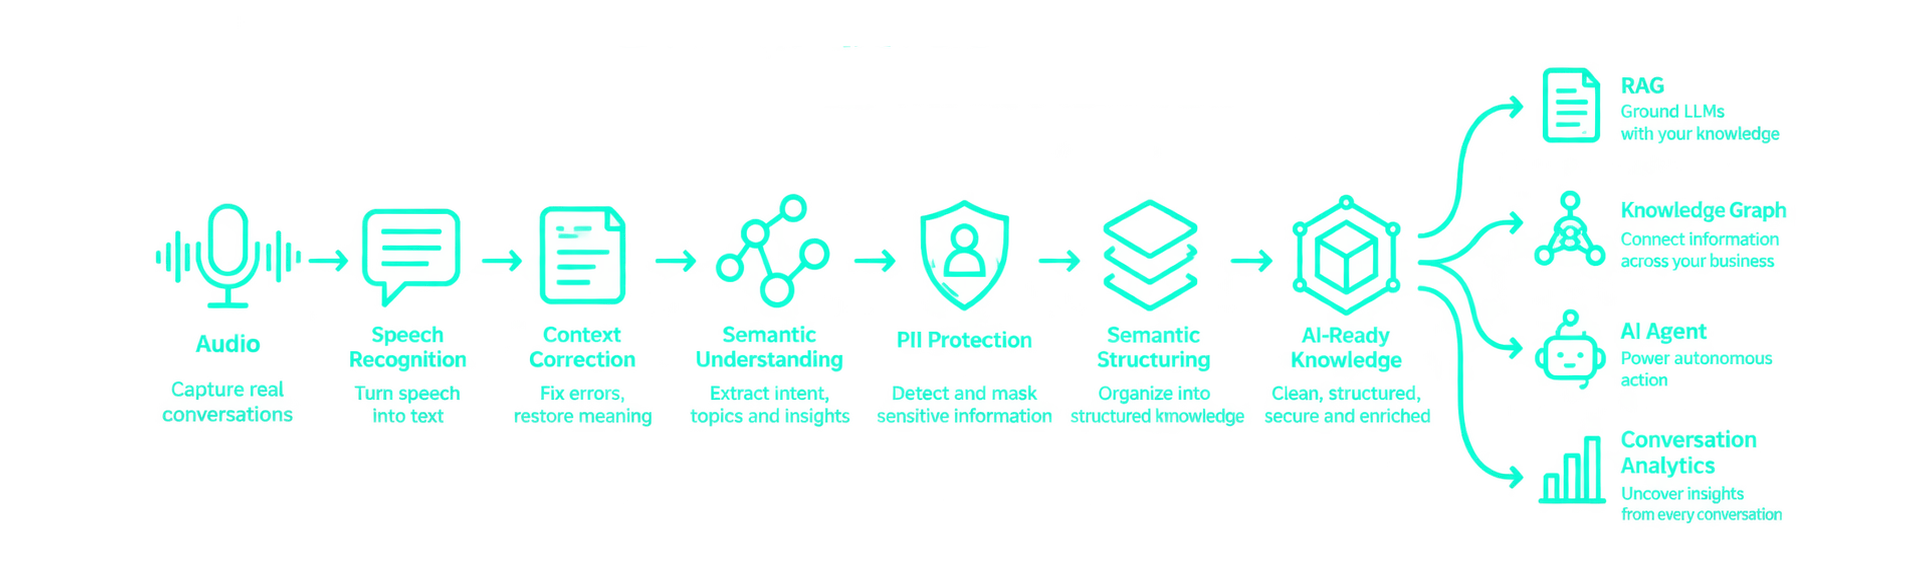
AIKNOW Voice phân tích ngữ cảnh, tổ chức lượt người nói và chủ đề, rồi tạo nội dung có cấu trúc cho các ứng dụng tri thức doanh nghiệp.
← Cuộn ngang →
Dùng ngữ cảnh hội thoại để làm rõ từ đồng âm và cách diễn đạt mơ hồ, tạo bản phiên âm dễ đọc. Bản phiên âm gốc được giữ để đối chiếu. Hiệu chỉnh theo ngữ cảnh vẫn có thể gây lỗi, nên cần đánh giá bằng các bản ghi đại diện.
Hỗ trợ tiếng Nhật và tiếng Anh, kể cả thuật ngữ tiếng Anh xen trong hội thoại tiếng Nhật. Có xử lý thuật ngữ chuyên ngành, tên riêng và con số; chất lượng nhận dạng phụ thuộc bản ghi và từ vựng của lĩnh vực.
Phân biệt lượt người nói, xử lý từ đệm và tiếng ồn không mong muốn để tạo dữ liệu hội thoại dễ đọc. Nhãn người nói dùng để phân biệt giọng, không tự xác nhận danh tính một người.
Tự động phát hiện và che các nhóm thông tin cá nhân được cấu hình như địa chỉ, số điện thoại và số thẻ tín dụng, trên văn bản. Âm thanh gốc không bị thay đổi. Độ chính xác được kiểm tra trên mẫu; vẫn có thể bỏ sót, nên chỉ che văn bản chưa đủ để bảo đảm dữ liệu đã được ẩn danh.
Nhóm các phát biểu theo chủ đề và ý nghĩa để những trao đổi liên quan có thể được truy xuất, phân tích cùng nhau.
Nội dung hội thoại có cấu trúc có thể tích hợp với ứng dụng RAG, đồ thị tri thức và hệ thống phân tích hội thoại. Kết nối và quyền truy cập được cấu hình theo hệ thống đích.
Kết quả xử lý được tự động đưa vào sử dụng, không bắt buộc duyệt từng kết quả. Trước triển khai, cần đánh giá phiên âm, nội dung AI suy luận và che thông tin trên mẫu đại diện. Với quyết định có ảnh hưởng lớn, cần đối chiếu bản phiên âm gốc và bản ghi âm nếu có.
Phiên âm và tổ chức cuộc gọi để phân tích yêu cầu, khiếu nại, quy trình xử lý và cách nhân viên phản hồi. Ứng dụng này tập trung phân tích tương tác; tự động hóa trao đổi trực tiếp với khách hàng thuộc phạm vi AIKNOW Answer.
Trích xuất nội dung chính và việc cần làm, gồm người phụ trách, thời hạn. Thông tin có thể được nói rõ hoặc do AI suy luận; người phụ trách và thời hạn suy luận là đề xuất cần xác nhận, không phải cam kết đã được thống nhất. Đầu ra có thể bổ sung vào tri thức dự án qua kết nối được cấu hình.
Phân tích hội thoại để phát hiện dấu hiệu chưa phù hợp chính sách hoặc hướng dẫn sai, phục vụ người phụ trách đánh giá. Bản phiên âm và văn bản đã che thông tin có thể dùng cho rà soát, kiểm toán nội bộ theo yêu cầu truy cập và xử lý dữ liệu. Nhận định của AI không tự xác lập việc tuân thủ hay vi phạm.
Chuyển cuộc gọi, cuộc họp và bản ghi hỗ trợ thành nội dung có cấu trúc để tìm kiếm và khai thác tri thức. Nguồn dữ liệu, tích hợp và phạm vi truy cập được xác định cho từng lần triển khai.
Chia sẻ môi trường ghi âm, ngôn ngữ và mục đích ứng dụng của bạn.
Chúng tôi có thể dùng mẫu đại diện để đánh giá chất lượng phiên âm, che thông tin và đầu ra có cấu trúc.