表・グラフ・数式に意味が埋め込まれている
重要な結論や条件が、文章ではなく、表の構造、グラフの変化、数式、図中の関係として表現されていることがあります。
テキスト抽出だけでは、その意味を正しく捉えることはできません。
 DOCUMENT INTELLIGENCE
文章・表・図・数式を読み取り、情報の構造と関係を整理する文書解析基盤
文字だけでなく、表の構造、図と文章の対応、ページをまたぐ文脈を解析します。生成AIと画像処理により、技術文書に埋もれた情報を取り出し、検索や分析に活かせるデータへ変換します。
設計資料、技術レポート、論文、仕様書などには、文章以外にも重要な情報が含まれています。
重要な結論や条件が、文章ではなく、表の構造、グラフの変化、数式、図中の関係として表現されていることがあります。
テキスト抽出だけでは、その意味を正しく捉えることはできません。
従来のOCRは「文字を認識する」ことを中心に設計されています。
複雑なレイアウトや複数の情報形式を持つ技術資料では、認識後に追加のルール処理や人による確認が必要になります。
PDFや画像をテキスト化しただけでは、文書構造や情報同士の関係が失われます。
そのままではRAGや生成AIから正確に利用することが困難です。
技術知識が大量の文書に埋もれ、エンジニアが必要な情報を手作業で探している。文書管理システム(DMS)も、ファイルの保管とキーワード検索にとどまっている。こうした状況も、よく見られる課題です。
技術文書は、文字の集まりではありません。
ページの構造と、要素どうしの関係まで理解して初めて、そこに含まれる知識を正しく活用できます。
AIKNOW Captureは、ページ全体を一つの文書として統合的に解析します。
報告書や学術文書の見出し、複数カラム、注釈などを認識します。
単純に文字を並べるのではなく、ページ本来の読み順と情報構造を捉えます。
複数カラムや複数ページに分断された文章でも、前後の関係を保持しながら読み取ります。
ページ単位ではなく、文書全体の文脈として理解します。
章・節・リスト・引用・脚注などを把握し、それぞれの階層関係を保持したままデータを整理します。
セル結合やチェックボックスを含む複雑な表を理解します。
数学・物理・化学などの数式を抽出し、LaTeX形式でも出力できます。
文章以外に含まれる情報も、同じページの一部として解析します。
かすれや傾きのある画像内の文字についても、OCR処理と組み合わせて認識します。
PDF、Word、Excelなど、多様な形式の文書に対応します。
過去に蓄積された資料から最新のデジタル文書まで、企業内の情報資産を活用できます。
従来のOCRが目指すのは、文字の読み取りです。AIKNOW Captureが目指すのは、文書をナレッジに変えることです。
文字を読み取ることがゴールです。
文字認識だけでは、表の行と列、グラフの傾向、図と本文の対応、ページをまたぐ文脈を保持するために追加の処理が必要です。
失われた意味の復元は、後工程のルール作成や人による確認に委ねられます。
文字・表・図の意味と、要素どうしの関係までを読み取ります。
画像と言葉を同時に扱い、固定テンプレートに限定せず、多様な文書を解析します。適用条件や補正処理は文書に合わせて調整します。
画像補正・レイアウト調整などの前処理と、照合・補正・信頼度評価などの後処理で、VLMだけでは安定しない数値・固有名詞・整合性を補います。
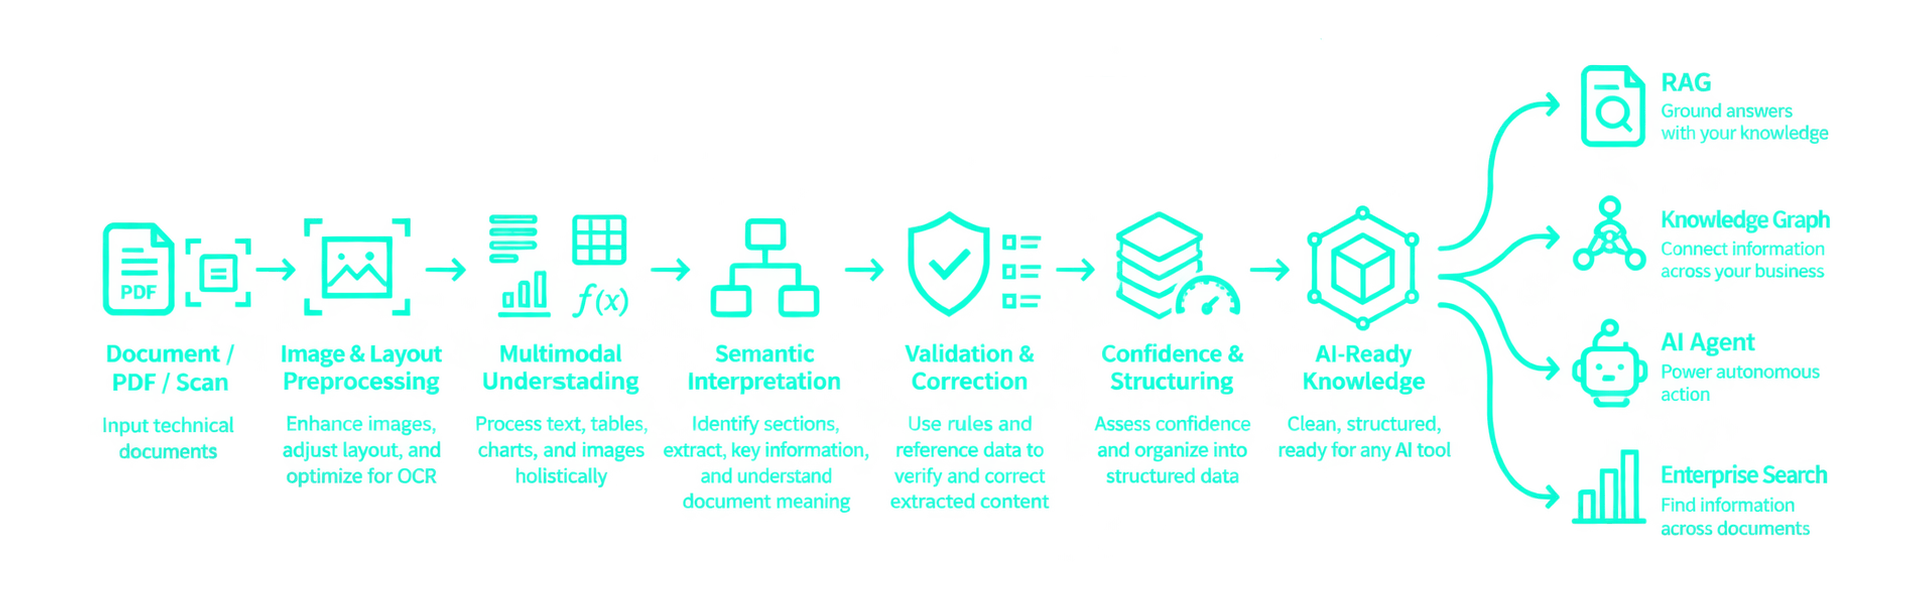
前処理から構造化までの5つの工程で、精度・速度・安定性を確保します。
← 横にスクロールできます →
文章以外の形で表現された情報も、文書の一部として統合的に解析します。
固定テンプレートなしで、形式の異なる文書を解析します。
日本語の文書を前提に、OCR・VLM・前後処理を組み合わせて認識の仕組みを組んでいます。
日本語の業務資料や技術資料をナレッジとして活用できる形へ変換します。
画像補正・位置調整から、照合・信頼度評価までを行います。
認識処理をGPU上で実行し、前処理や照合、信頼度算出などの処理をCPU側で並行して実行します。
文書処理全体のスループットを高めます。
単なるOCRテキストではなく、文書の構造と意味を保持したデータへ変換します。
RAGやナレッジグラフで利用できる形へ出力します。抽出結果は自動で利用し、文書種別ごとの認識品質と信頼度指標の有用性はPoCで検証します。
VLMとGPUを組み合わせた処理構成により、当社の検証では、参照方式と比べてサーバー1台あたりの処理性能が約30倍になりました(条件は下記)。
約30倍 の処理スループット
1台あたりのページ処理性能での比較値です。
※内部ベンチマーク。同じ2ページの手書きフォームを使用し、20回測定しました。CPUとRAMは同じ構成で、検証方式にはNVIDIA L40 GPUを追加しています。実行多重度も異なるため、方式単体の優劣や本番環境の性能を保証する比較ではありません。認識サーバー36台と4台は、それぞれの検証構成を示します。
過去の設計資料、仕様書、検証レポートなどを解析し、エンジニアが必要な技術情報を検索・再利用できるナレッジベースを構築します。
図表や数式を多く含む学術・技術文書を解析します。
研究結果や技術情報を横断的に活用できます。
複雑な章構造、表、図を含む製品マニュアルや仕様書を構造化します。
RAGやAIアシスタントから利用できるナレッジへ変換します。
紙文書やスキャンされた過去資料を単にデジタル化するのではなく、その内容を検索・分析・再利用できる企業ナレッジへ変えます。
文書の種類、必要な出力、検索・分析などの用途をお聞かせください。代表的な文書を使い、AIKNOW Captureの抽出結果と業務への適用方法を確かめます。
文書解析のデモ・検証を相談する