文脈が失われ、誤認識が起きる
短い音声単位だけでは会話全体の意味を捉えられず、同音異義語や専門用語を誤って認識することがあります。
 SPEECH INTELLIGENCE
会話の文脈まで踏まえて、AIで活用できるナレッジへ変換する音声インテリジェンス基盤
通話・会議・顧客対応の音声を、会話の文脈を踏まえて文字にします。話者の分離、個人情報のマスキング、話題ごとの分割までを一つの流れで処理し、RAGやナレッジグラフで使いやすいデータに整えます。
従来の音声認識は、「音を文字にする」ことを目的として設計されています。
しかし、実際の会話には、ノイズ、言い淀み、同音異義語、専門用語、固有名詞、数字、複数言語の混在など、認識を難しくする要素が多く含まれます。
短い音声単位だけでは会話全体の意味を捉えられず、同音異義語や専門用語を誤って認識することがあります。
話者の識別、フィラー除去、文章整形、重要箇所の抽出など、分析前に多くの前処理が必要です。
音声データには個人情報が含まれ、文字起こし結果も長くなるため、そのままではRAGや生成AIで扱いにくいのが実情です。
音声を文字へ変換することがゴールです。
従来の音声認識は、主に声の音響的な特徴から文字の候補を推定します。前後の文脈を踏まえた判断には限りがあり、同音異義語の多い日本語では誤認識につながりやすくなります。
文字起こしは、ゴールではありません。
AIKNOW Voiceは会話の文脈と意味を理解し、音声から企業が利用できる「ナレッジ」を生成します。
← 横にスクロールできます →
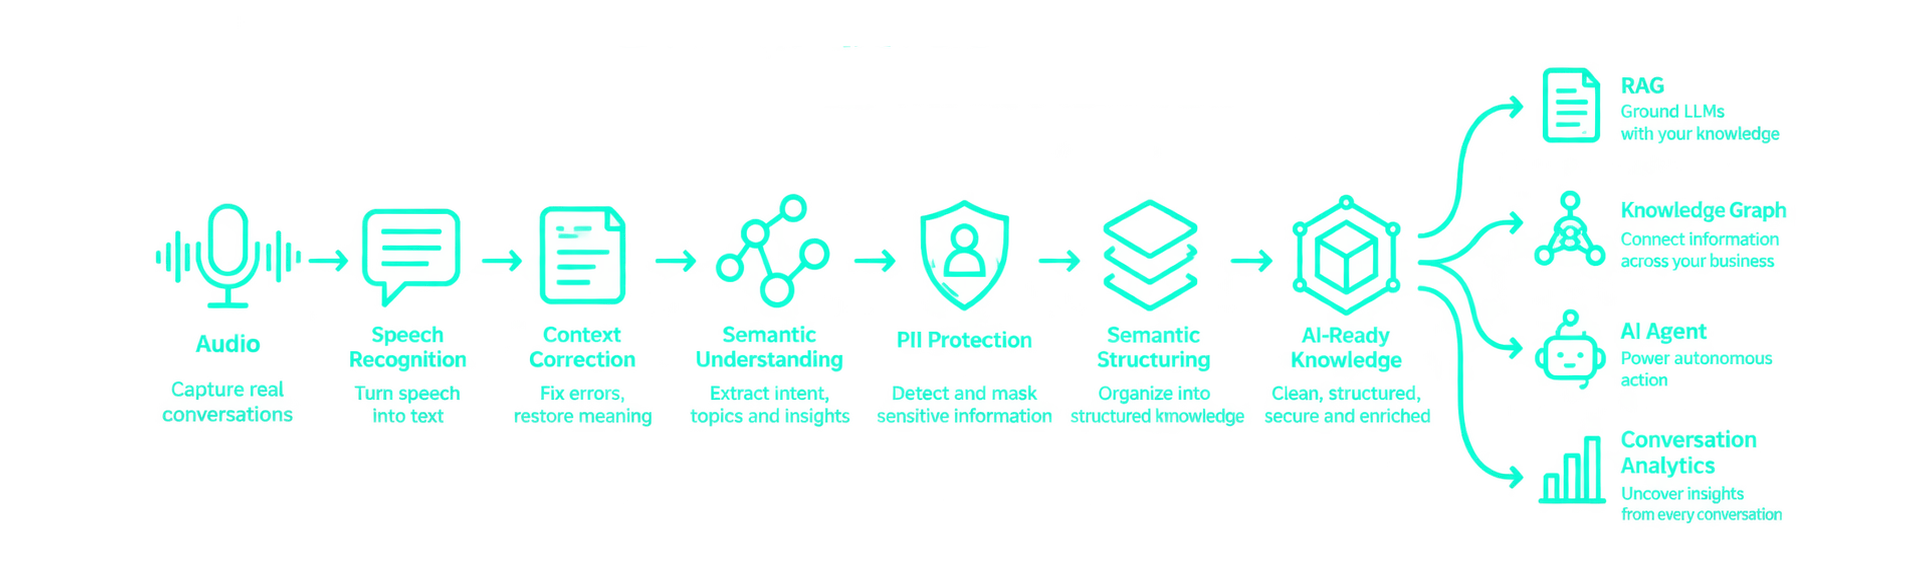
長い会話の文脈を保持し、意味的な推論によって同音異義語や曖昧な発話を補正します。生成AIを活用し、読みやすく意味の通る文字起こしを生成します。
専門用語や固有名詞に加え、日本語の会話に英語が混ざる場合や、電話番号などの数字にも対応します。
話者を識別して各発話を分離します。「えー」「あのー」などのフィラーや不要なノイズを処理し、読みやすい会話データへ整えます。
住所、電話番号、クレジットカード番号などの個人情報を処理パイプライン上で検出・マスキングし、安全な社内利用を支援します。
固定文字数ではなく、話題、意味、重要な発言のまとまりに基づいて文字起こしを自動分割します。
整形・構造化された音声データを、RAG、ナレッジグラフ、会話分析、AI学習データなどへ接続できます。
顧客との通話を文字起こし・構造化し、問い合わせ内容、クレーム、対応プロセス、オペレーター応対などの分析に活用できます。
会議内容を記録するだけでなく、重要な議論、アクションアイテム、担当者、期限などを抽出し、プロジェクトナレッジとして蓄積します。
応対内容を分析し、規定違反や誤案内の確認を支援。個人情報を保護しながら内部レビューや監査へ利用できます。
通話、会議、サポート履歴など、これまで検索・再利用が難しかった音声データをRAGやナレッジグラフへ統合し、企業のナレッジ資産へ変換します。
これまで十分に活用されてこなかった企業の音声データを、
AIが理解し、検索し、分析し、再利用できるナレッジへ。