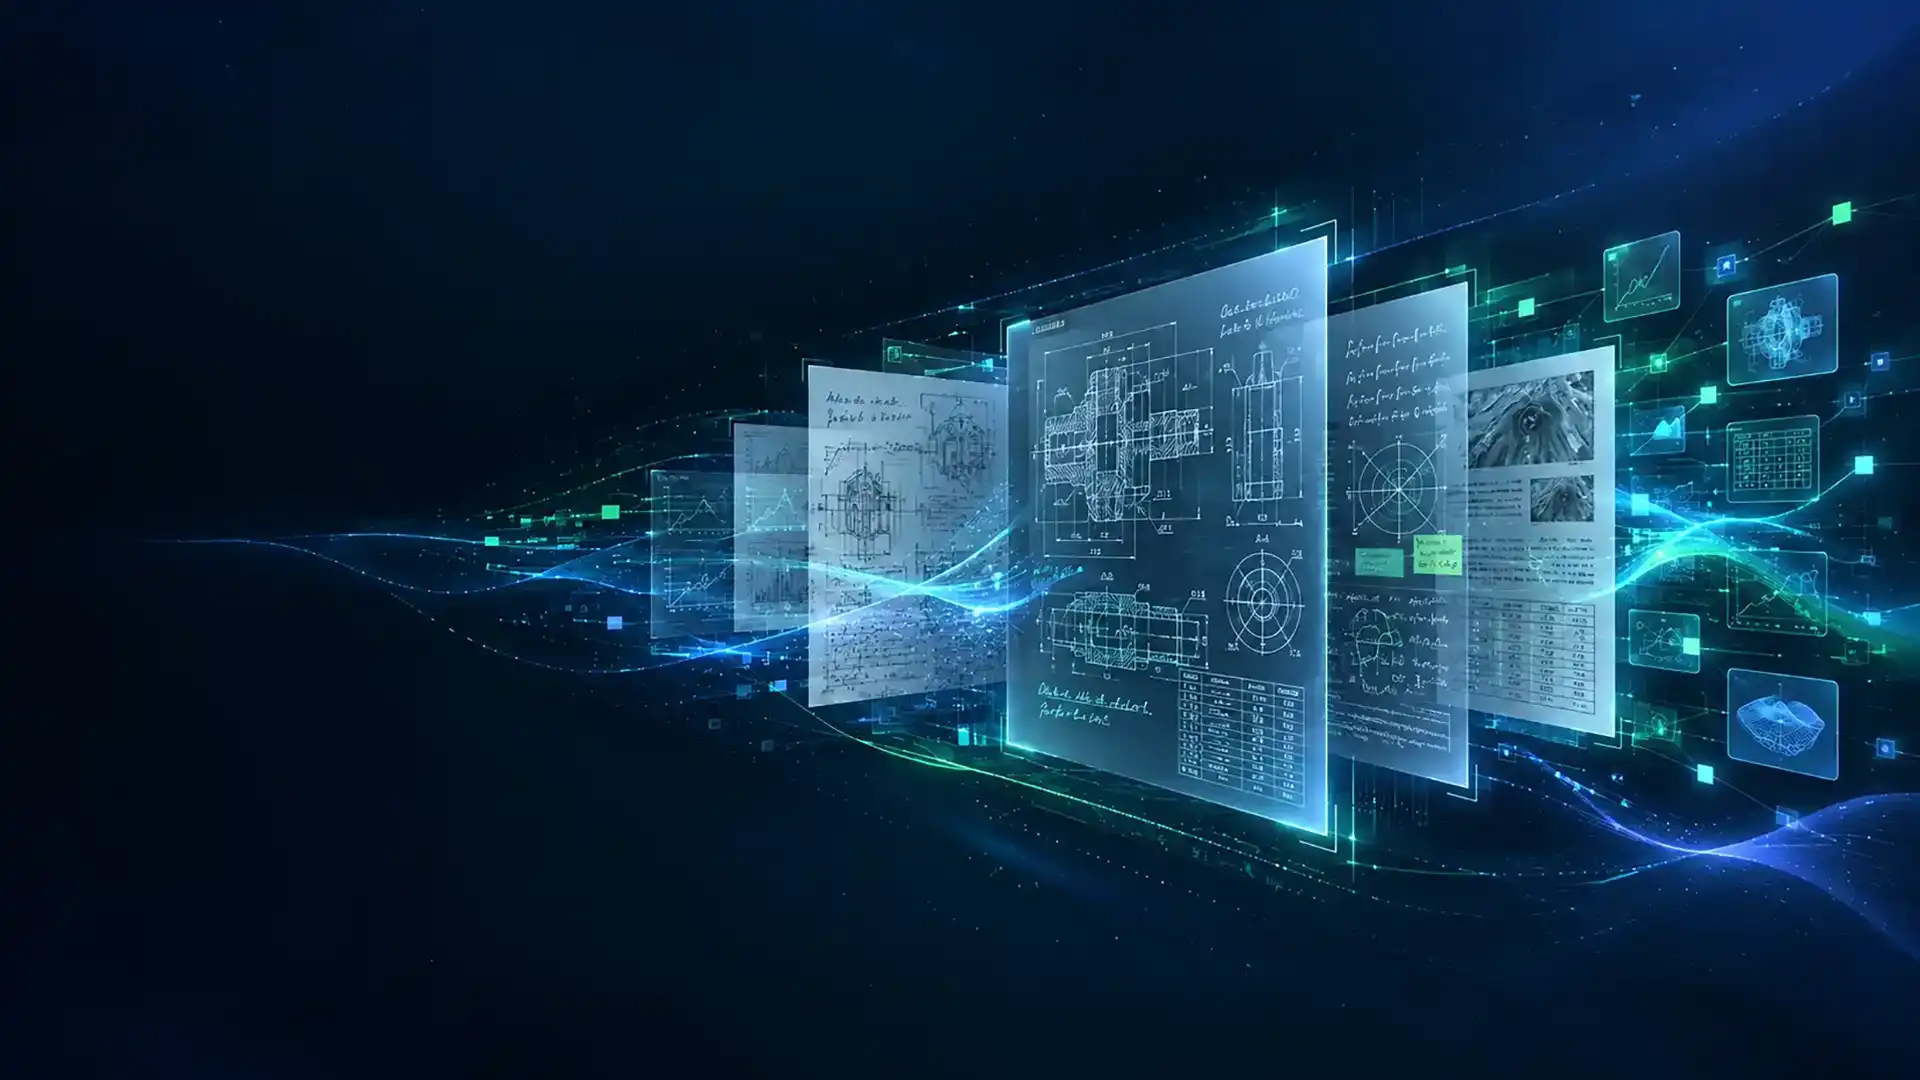
表・グラフ・数式に意味が埋め込まれている
重要な結論や条件が、文章ではなく、表の構造、グラフの変化、数式、図中の関係として表現されていることがあります。
テキスト抽出だけでは、その意味を正しく捉えることはできません。
 DOCUMENT INTELLIGENCE
複雑な技術文書を、AIが使えるナレッジへ変換する文書解析基盤(ドキュメントインテリジェンス)
表・グラフ・設計図・数式まで含む技術文書を、画像と文章をあわせて理解する生成AI(VLM)と、画像処理・レイアウト解析を組み合わせて解析します。文字の読み取りにとどまらず、意味を持つナレッジへ変換します。
設計資料、技術レポート、論文、仕様書などには、文章以外にも重要な情報が含まれています。
重要な結論や条件が、文章ではなく、表の構造、グラフの変化、数式、図中の関係として表現されていることがあります。
テキスト抽出だけでは、その意味を正しく捉えることはできません。
従来のOCRは「文字を認識する」ことを中心に設計されています。
複雑なレイアウトや複数の情報形式を持つ技術資料では、認識後に追加のルール処理や人による確認が必要になります。
PDFや画像をテキスト化しただけでは、文書構造や情報同士の関係が失われます。
そのままではRAGや生成AIから正確に利用することが困難です。
技術知識が大量の文書に埋もれ、エンジニアが必要な情報を手作業で探している。文書管理システム(DMS)も、ファイルの保管とキーワード検索にとどまっている。こうした状況も、よく見られる課題です。
技術文書は、文字の集まりではありません。
ページの構造と、要素どうしの関係まで理解して初めて、そこに含まれる知識を正しく活用できます。
AIKNOW Captureは、ページ全体を一つの文書として統合的に解析します。
報告書や学術文書の見出し、複数カラム、注釈などを認識します。
単純に文字を並べるのではなく、ページ本来の読み順と情報構造を捉えます。
複数カラムや複数ページに分断された文章でも、前後の関係を保持しながら読み取ります。
ページ単位ではなく、文書全体の文脈として理解します。
章・節・リスト・引用・脚注などを把握し、それぞれの階層関係を保持したままデータを整理します。
セル結合やチェックボックスを含む複雑な表を理解します。
数学・物理・化学などの数式を抽出し、LaTeX形式でも出力できます。
文章以外に含まれる情報も、同じページの一部として解析します。
かすれや傾きのある画像内の文字についても、OCR処理と組み合わせて認識します。
PDF、Word、Excelなど、多様な形式の文書に対応します。
過去に蓄積された資料から最新のデジタル文書まで、企業内の情報資産を活用できます。
従来のOCRが目指すのは、文字の読み取りです。AIKNOW Captureが目指すのは、文書をナレッジに変えることです。
文字を読み取ることがゴールです。
一文字ずつ正確に読めても、表の行と列の関係、グラフが示す傾向、図と本文の対応、ページをまたぐ文脈は失われます。
失われた意味の復元は、後工程のルール作成や人による確認に委ねられます。
文字・表・図の意味と、要素どうしの関係までを読み取ります。
画像と言葉を同時に扱い、テンプレートや個別ルールに頼らず、多様な文書を読み解きます。
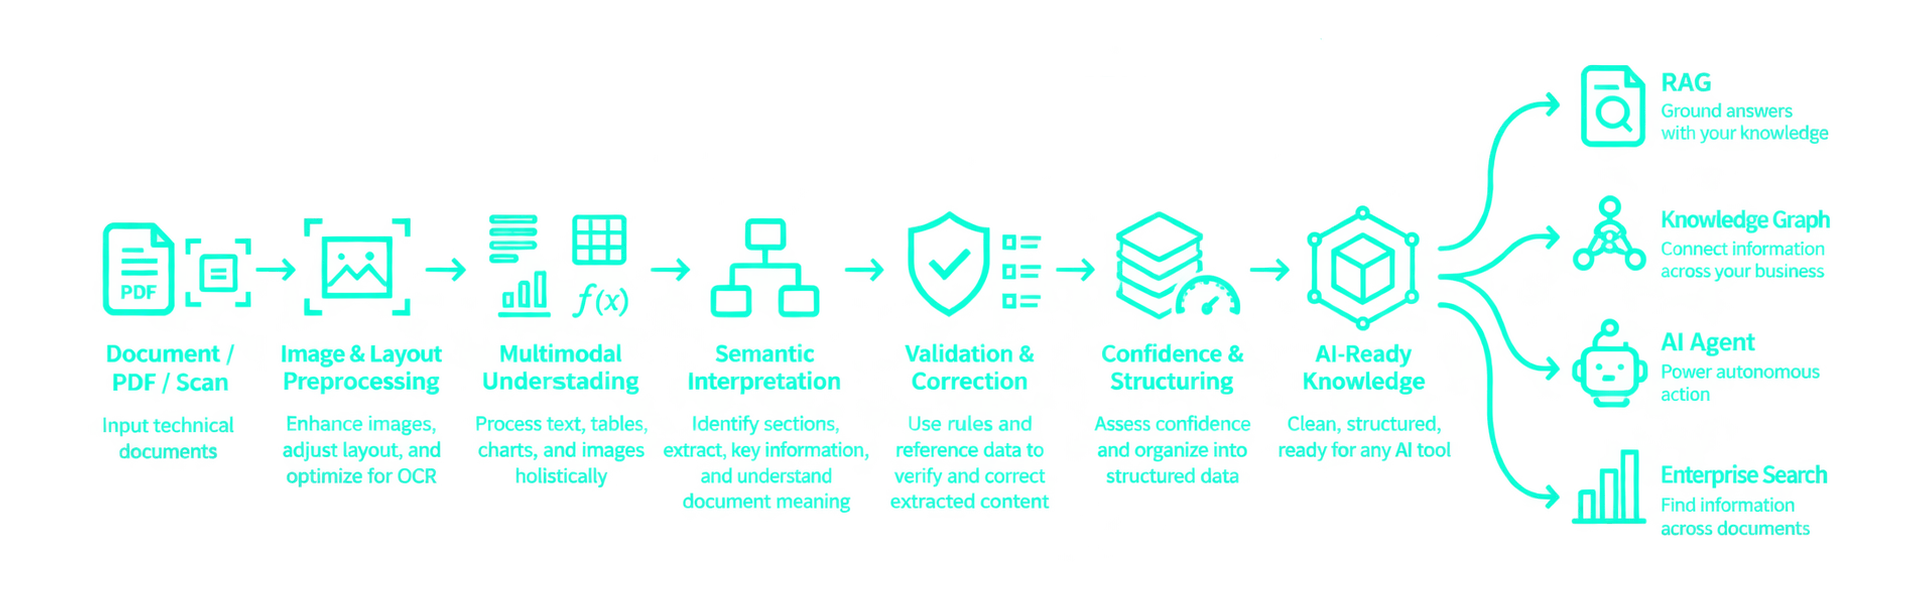
画像補正・レイアウト調整などの前処理と、照合・補正・信頼度評価などの後処理で、VLMだけでは安定しない数値・固有名詞・整合性を補います。
前処理から構造化までの5つの工程で、精度・速度・安定性を確保します。
← 横にスクロールできます →
文章以外の形で表現された情報も、文書の一部として統合的に解析します。
固定テンプレートなしで、形式の異なる文書を解析します。
日本語の文書を前提に、OCR・VLM・前後処理を組み合わせて認識の仕組みを組んでいます。
日本語の業務資料や技術資料をナレッジとして活用できる形へ変換します。
画像補正・位置調整から、照合・信頼度評価までを行います。
認識処理をGPU上で実行し、前処理や照合、信頼度算出などの処理をCPU側で並行して実行します。
文書処理全体のスループットを高めます。
単なるOCRテキストではなく、文書の構造と意味を保持したデータへ変換します。
RAG、ナレッジグラフ、生成AIなどのナレッジ基盤へ接続できます。
VLMとGPUを組み合わせた処理構成により、当社の検証では、参照方式と比べてサーバー1台あたりの処理性能が約30倍になりました(条件は下記)。
約30倍 の処理スループット
1台あたりのページ処理性能での比較値です。
※当社検証環境における参考値です。両方式では実行多重度などの条件が異なるため、比較可能な指標は主に1台あたりのページ処理性能です。認識サーバー構成についても、参照方式の36台に対し、検証構成では4台という結果が示されています。
過去の設計資料、仕様書、検証レポートなどを解析し、エンジニアが必要な技術情報を検索・再利用できるナレッジベースを構築します。
図表や数式を多く含む学術・技術文書を解析します。
研究結果や技術情報を横断的に活用できます。
複雑な章構造、表、図を含む製品マニュアルや仕様書を構造化します。
RAGやAIアシスタントから利用できるナレッジへ変換します。
紙文書やスキャンされた過去資料を単にデジタル化するのではなく、その内容を検索・分析・再利用できる企業ナレッジへ変えます。
AIKNOW Captureが、複雑な文書に埋め込まれた情報を読み取り、理解し、構造化します。
企業の文書を、検索・分析・推論・再利用できるナレッジへ。